Herberth Cuba
Los médicos y el diagnóstico asistido por IA
El diagnóstico secuencial de Microsoft y la brecha entre estudio y difusión
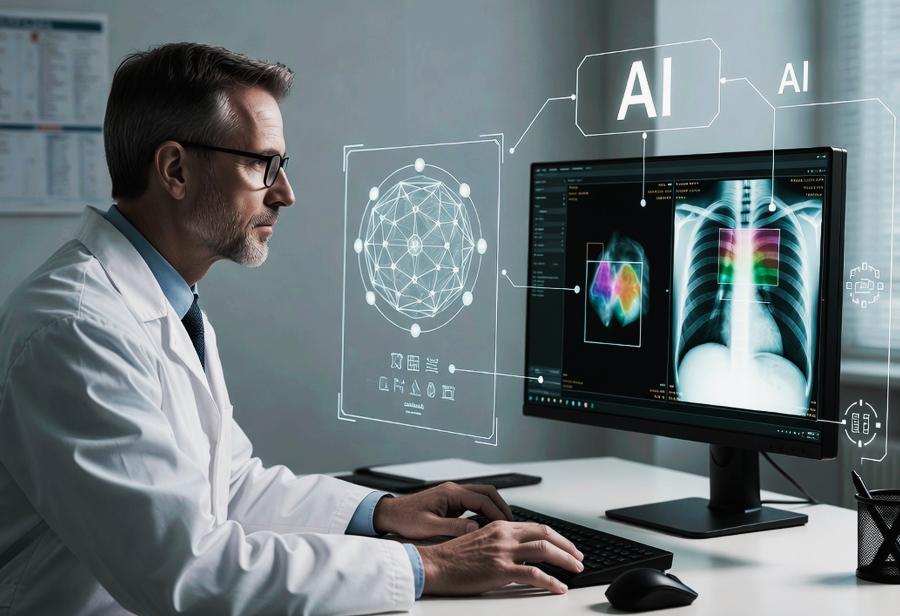
El 21 de octubre de 2026, Microsoft publicó un comunicado titulado "Construyendo superinteligencia médica" (Building Medical Superintelligence)(1) en el que anunciaba que su sistema de diagnóstico por inteligencia artificial había superado a los médicos generalistas en pruebas controladas. Ese mismo día, la revista Science publicó el artículo académico correspondiente, titulado "Diagnóstico secuencial con modelos de lenguaje" (Sequential diagnosis with language models)(2). Entre ambos textos existe una distancia que es necesario examinar con detalle, junto con el contexto en que se ha dado esa relación entre la ciencia y el marketing empresarial.
El estudio académico construyó un entorno de prueba interactivo con 304 casos complejos del New England Journal of Medicine y 325 casos de urgencias de una base de datos hospitalaria de Boston. Tanto la inteligencia artificial como los médicos humanos partían de una queja inicial breve y debían decidir qué preguntar y qué pruebas solicitar antes de comprometerse con un diagnóstico. El sistema de lenguaje de Microsoft, denominado Orquestador de Diagnóstico, coordinaba varios agentes que debatían entre sí, proponían hipótesis y evaluaban costos. Los resultados fueron los siguientes: en los casos complejos, la inteligencia artificial acertó el 83.2% de las veces, mientras que los médicos generalistas acertaron el 36.1% cuando disponían de materiales de referencia y aproximadamente el 22% cuando no los tenían. En los casos de urgencias, la inteligencia artificial alcanzó el 80.3% y los médicos el 46.8%, y falló en el 19.7% restante. El artículo también señala que el sistema formuló un promedio de 25.5 preguntas antes de pedir la primera prueba, frente a las 5.6 preguntas de los médicos(3).
El comunicado de Microsoft, en cambio, presenta estos datos con un lenguaje que transforma un hallazgo de laboratorio en una promesa clínica. Afirma que el sistema es 1.7 veces más preciso que los médicos en urgencias y más del doble en casos complejos, y que lo logra a la mitad o incluso a un tercio del costo. Sin embargo, el comunicado no dice con la misma claridad que esos costos son estimaciones simuladas, que no hubo pacientes reales, que los médicos comparados trabajaban solos y con recursos limitados, y que los propios autores del artículo académico admiten que la brecha se estrecharía frente a especialistas o equipos multidisciplinarios. Además, hay que señalar que Microsoft financió la investigación, la condujo con sus propios investigadores y la anunció con una campaña de comunicación coordinada. Los medios reprodujeron el titular de que la inteligencia artificial supera a los médicos sin matizar las condiciones del experimento.
Un blog del British Medical Journal ya había advertido, sobre las versiones preliminares del estudio, que a los médicos se les restringió el acceso a libros de texto, recursos de imagen, colaboración con colegas y retroalimentación en tiempo real(4); tampoco accedieron al paciente real. La comparación, por tanto, no mide a la inteligencia artificial contra un médico en condiciones normales, sino contra un médico deliberadamente limitado. El titular, "una máquina que supera a médicos", contrasta con el artículo científico que señala que "las sesiones no capturaron datos multimodales como imágenes, formas de onda o laminillas de patología, ni la riqueza completa de los encuentros con pacientes"(2). Es decir, el sistema no operó con los cinco sentidos del ser humano, que condicionan la práctica clínica médica concreta, información recabada que, a veces, no se puede reducir a un texto. La relación médico-paciente es una relación entre dos personas que mantienen un vínculo en el que el uso de los cinco sentidos, la confianza, la presencia, el tiempo compartido y la interpretación de silencios tienen valor diagnóstico y terapéutico. En el estudio de Microsoft, esa relación no existió, porque el paciente era un archivo de texto y el médico era un programa que hacía preguntas a otro programa.
El estudio actual fue retrospectivo, sobre registros históricos, y financiado por la empresa que desarrolló el sistema. El paso que Microsoft anuncia es una evaluación prospectiva en el Beth Israel Deaconess Medical Center de Boston, necesario, no suficiente, porque se limitaría a comparar diagnósticos en un entorno controlado. El paso decisivo serían estudios que midan desenlaces en pacientes reales; sin embargo, se necesitarían normas regulatorias y financiación independiente para los futuros ensayos clínicos entre la inteligencia artificial y los pacientes. Los ensayos deben incorporar pacientes reales con información incompleta y ambigua, evaluación física y datos sensoriales como parte del proceso, pero además, que los resultados se comparen contra equipos de especialistas y contra la práctica clínica habitual, con medición de desenlaces duros como mortalidad, complicaciones, reingresos y tiempo hasta el tratamiento correcto.
En la regulación ya hay avances. Por ejemplo, las extensiones de las guías SPIRIT y CONSORT para inteligencia artificial, introducidas en 2020, ofrecen directrices para protocolos y para el reporte de ensayos con inteligencia artificial, con la inclusión de la descripción detallada de la interacción entre humanos y sistemas automatizados y el análisis de errores. En el Perú, en una carta publicada en Acta Médica Peruana (5) se señala que estas guías buscan garantizar la transparencia, la reproducibilidad y la validez de los estudios, y que es necesario actualizar los protocolos éticos para que los participantes comprendan las implicancias del uso de inteligencia artificial en sus datos. Además, antes de comenzar, se debe registrar el protocolo que defina qué se medirá y qué se considerará una falla del sistema, y que exija que se evalúe de forma independiente a los desarrolladores y establecer mecanismos claros de responsabilidad legal cuando un sistema contribuya a un diagnóstico erróneo.
El rol del médico y la defensa de la ética médica en este nuevo escenario es clave, porque la inteligencia artificial, por sí misma, no puede cumplir el principio "primum non nocere". "Primero no dañar" es un principio que no se limita solo a la medicina, sino que rige la política, la economía, la cultura, lo social, la interculturalidad y la ecología; es decir, cualquier aspecto del comportamiento humano(6). Ese principio también rige la convivencia entre pueblos, culturas, etnias, lenguas, religiones e ideologías(7). La literatura científica advierte que existe una probabilidad de que el uso de estas herramientas cause daño. Los riesgos incluyen la perpetuación de sesgos algorítmicos, la falta de claridad sobre la responsabilidad clínica, las violaciones de la privacidad y la tendencia a generar contenido incorrecto que parezca verosímil. Por ejemplo, el propio estudio que comentamos señala que "cuando el registro histórico no contenía la respuesta a las preguntas, podía generar una respuesta sintética plausible"(2). Esa capacidad, que en el laboratorio sirve para mantener la simulación, en la práctica clínica concreta podría convertirse en una fuente de información falsa con apariencia de dato clínico.
En esa línea, BMJ Health & Care Informatics (8) clasifica las aplicaciones en cuatro niveles de riesgo y establece que, en los niveles alto y crítico, se requiere validación clínica formal, supervisión humana continua y, en el caso de aplicaciones críticas como el diagnóstico autónomo sin validación del clínico, la recomendación actual es evitar su despliegue rutinario. El sistema de Microsoft, tal como se presentó en el estudio, operaba sobre casos históricos y sin pacientes reales. No hay evidencia de que estuviera diseñado para funcionar de forma autónoma en un entorno clínico. Sin embargo, mediante el marketing se presentó como un avance que supera a los médicos, lo que podría empujar a los servicios de salud a adoptar el sistema sin que se hayan realizado los estudios que la ética exige. El médico no puede delegar la responsabilidad.
En ese sentido, un marco práctico publicado en el Journal of Hospital Medicine y difundido por el American College of Physicians (9) propone cinco pasos para el uso de estos sistemas en el diagnóstico: elegir la tarea adecuada, seleccionar el modelo adecuado, proporcionar la información adecuada, revisar y reconciliar la salida con el juicio propio, y reflexionar sobre el razonamiento. Es decir, el cuarto y el quinto paso son los que materializan el principio de primero, no dañar. El médico debe revisar la recomendación de la máquina, contrastarla con su propia evaluación y documentar por qué acepta o rechaza lo que el sistema propone. Sin embargo, debido a la omnipresencia de la IA, existe el riesgo de que los médicos pierdan habilidades clínicas, o ingresen a un proceso de desaprendizaje, sobre todo los que se encuentran en formación. Un médico que nunca ha tenido que construir un diagnóstico desde cero, equivocándose y corrigiendo, difícilmente podrá evaluar críticamente lo que una máquina le sugiere. La ética médica, primero no dañar, incluye el deber de preservar la competencia profesional para tener la capacidad de proteger al paciente. ¡Primero, no dañar!
Referencias
(1) Microsoft AI. "Building Medical Superintelligence" (Construyendo superinteligencia médica), 21 de octubre de 2026. https://microsoft.ai/news/building-medical-superintelligence/
(2) Nori, H. et al. "Sequential diagnosis with language models" (Diagnóstico secuencial con modelos de lenguaje).Science, 394, 423-428, 2026. https://www.science.org/doi/10.1126/science.aeh7930
(3) Nori, H. et al. "Sequential diagnosis with language models" (Diagnóstico secuencial con modelos de lenguaje). Science, 394, 423-428, 2026. https://www.science.org/doi/10.1126/science.aeh7930
(4) Carvalho, C., Madden, M. y Paramsothy, R. "AI vs doctors: The wrong question for healthcare's future" (Inteligencia artificial frente a médicos: la pregunta equivocada para el futuro de la sanidad). British Medical Journal Blogs, 10 de septiembre de 2025. https://blogs.bmj.com/bmjleader/2025/09/10/ai-vs-doctors-the-wrong-question-for-healthcares-future-by-clarissa-carvalho-mary-madden-remi-paramsothy/
(5) Gómez Rázuri, K. G. "Inteligencia artificial en ensayos clínicos: ¿estamos preparados para sus implicancias éticas y regulatorias?". Acta Médica Peruana, 41(4), 307-308, 2024. https://amp.cmp.org.pe/index.php/AMP/article/view/3411
(6) Cuba García, H. "La libertad y el daño". El Montonero. https://www.elmontonero.pe/columnas/la-libertad-y-el-dao
(7) Cuba García, H. "Día Mundial de la Ética Médica". El Montonero. ://www.elmontonero.pe/columnas/dia-mundial-de-la-etica-medica
(8) Mohammad, M., Jimenez-Solem, E., Hejmadi, M. y Pihl, A. "Self-regulating the use of large language models in clinical practice: a risk-stratified approach". BMJ Health & Care Informatics, 33(1), e101921, 2026. https://doi.org/10.1136/bmjhci-2025-101921
(9) Barish, P., Auerbach, A. D. y Ranji, S. R. "The 5R's of large language model-assisted diagnosis: A practical framework for hospitalists". Journal of Hospital Medicine, 2026. https://doi.org/10.1002/jhm.70390
COMENTARIOS